认识自己,从日常开始。OHMEE / PRODUCT SCREENS
AI 产品经理 · AI 产品设计师
让复杂的 AI变得自然。
你好,我是徐晓萌,欢迎来到我的个人作品集网站!
我擅长理解用户心理、设计 AI 产品机制,并致力于在逻辑与直觉之间,建立清晰、有感知力的产品。
SELECTED WORK · 2023—2025
最近在做的事
两个认真长大的产品,
和两个保持好奇的小实验。
PLAYGROUND
早期练习 / 快速实验
AIPM CAPABILITIES
从机会判断,
到产品落地。
不止于定义功能。我关注 AI 能力如何转化为真实用户价值,以及产品如何持续迭代。
产品策略
用户研究 · 机会识别 · 产品定位
Roadmap · 指标体系
AI 产品设计
LLM 工作流 · Prompt / Context
评测体系 · Human-in-the-loop
验证与交付
PRD · 快速原型 · 用户测试
数据分析 · 迭代实验
跨团队协作
设计 / 算法 / 工程协同
目标对齐 · 项目推进
WORKING WITH
Figma
Cursor
SQL
Python
LLM APIs
Analytics
ABOUT ME理解技术,
理解技术,
也理解人。
PRODUCT / TECHNOLOGY / PEOPLE
我是一名正在寻找新机会的 AI 产品经理,擅长把技术能力转化成清晰、可验证的产品方案。
过去 4 年,我从 0 到 1 参与产品策略、用户研究与体验落地。比起追逐每一个新模型,我更关心它如何解决真实问题,并形成长期价值。
设计背景让我对体验细节敏感,产品训练则让我从目标、约束与结果出发。我喜欢与算法、工程和设计一起,把模糊问题推进到可以上线。
日常记录 → 能力被看见
MY ROLE
从用户研究,做到真实用户手里。
2026.06 — 至今 · MVP 持续迭代- MVP 测试用户
- 50+
- 三周留存
- >30%
- 用户消息分析
- 553
01 / THE QUESTION
做过的那些小事,
能不能成为认识自己的证据?
“爱你老几”“强者思维”“自我主体性”等话题反复出现,背后是年轻人对正反馈和自我认知的需要。许多人习惯强调失败,却很少认真看见已经做成的事。
我把切入点放在负面的自我叙事:如果记录日常时,有机会换一种看待自己的方式,会发生什么?
02 / FINDING THE SIGNAL
先听见需要,
再决定做什么。
从竞品、概念测试到一对一访谈,为一个足够具体的产品入口找依据。
寻找自我认知的切入口
研究 Tolan、Mindsera、Mindcraft、Mindback 的目标人群、AI 能力边界和商业模式,寻找围绕日常经历与身份认领的差异化空间。
把概念交给真实的人
用 Figma 和 UI 概念测试市场反馈,结合社媒内容反馈与目标用户访谈,确定 MVP 的核心定位、使用场景和功能范围。
- 用户加群
- 200+
- 内容互动率
- 12.5%
- 目标用户深访
- 5 位
加群人数是早期兴趣信号,与后续进入 MVP 测试的用户数量分别记录。
03 / THE EXPERIENCE
还是自己的经历。
试着换个说法。
用第一人称重新表达,让鼓励听起来像来自自己。下面这段对话取自现有产品截图。
A SMALL SHIFT IN PERSPECTIVE
从建筑自学到aipm
我主动从建筑自学到AI产品管理,跨越领域壁垒这件事让我看到了自己掌握新技能的能力。
同一段经历,另一种看见自己的方式。被看见的能力 自学者点击「换个说法」试试看 →
从自然的访谈开始
先聊经历,再进入记录,降低第一次使用的心理摩擦。
保留表达的主动权
AI 重写可以自由开关,记录仍然属于用户自己。
把能力慢慢认领回来
从输入中提炼可视化身份标签,探索持续使用的理由。
再看看首次进入产品的流程
04 / DESIGNING THE SYSTEM
轻松的体验背后,
是具体的取舍。
从首次体验、等待感和长期记忆出发,把抽象的产品假设拆成可以实现、测试和调整的机制。
先看到自己的记录
可视化数据本地存储,后台异步更新。让界面保持响应,减少等待对测试体验的干扰。
降低开始使用的顾虑
用匿名 ID 绑定数据库,以 PWA 进行测试,并清楚说明输入将用于产品迭代。
把更新频率当作假设
初始设定为每 6 轮输入更新画像,用真实使用反馈寻找合适的更新频率。
让用户感觉在帮助自己
保留第一人称与 AI 开关,用轻松的绿色、粉色和身份卡片,形成区别于心理咨询的使用氛围。
PRODUCT FLOW
从第一次访谈,到画像更新。
AI WORKFLOW
让每个节点,
只解决清楚的问题。
围绕 MVP 拆分意图识别、重写、评论和画像维护,降低 Prompt 优化的难度,控制回复等待与测试成本。
展开技术设计与实现
节点与记忆
Intent、Rewrite、AI Comment、Profile Maintenance、Compact。通过结构化字段和分节点 Prompt 约束生成行为,区分当前事件、行为模式、长期身份和上下文压缩信息。
- 前端
- Next.js · React · TypeScript · PWA
- 持久化
- IndexedDB · Supabase / PostgreSQL
- 模型接入
- DeepSeek · Gemini · OpenRouter
05 / MAKING IT REAL
做出来,
也给每次优化留下依据。
对齐 PRD 完成全栈 MVP,把提示词测试做成可重复运行的工作流程。
自己搭一个 Prompt Lab
为多节点 Workflow 搭建批量测试框架,创建测试集,横向对比模型输出。真实用户进入后,把 bad case、good case 和边缘 case 加入测试集,继续迭代。
- LLM 对比
- 5
- 初期测试
- 10+ 轮
- 内测后优化
- 3+ 轮
设计与实现保持对齐
用 Figma、Figma Make、Google Stitch、Claude 和 Codex 推进 UIUX。开发过程中手动维护 PRD、agent.md、plan 和 task,以 API、架构和 UI 文档保持前后端一致。
查看设计工作区与模型选型记录
当前项目记录中的模型选型为 Gemini 3 Flash 与 DeepSeek 4 Flash;通过横向测试后进入多轮 Prompt 优化。
06 / LISTEN, THEN ITERATE
把反馈,
带回下一次产品决策。
从真实输入里找线索553条
用户消息聚类分析
看行为,也听用户怎么说。
结合使用漏斗、消息聚类和 1 对 1 深访,理解用户从首次体验到持续使用的问题,再调整访谈引导、身份页面与 Prompt 机制。
首次体验身份认领持续使用
形成 5 类分析画像,关注 5 位较高粘性用户的使用方式。分析分组与用户人数分别记录。
07 / EARLY SIGNALS, NEXT QUESTIONS
有一些信号,
值得继续做下去。
在不同用户画像中,观察到对第一人称改写和身份认领的积极反馈。现阶段,证据支持继续迭代。
- MVP 测试用户
- 50+
- 较高粘性用户
- 5
- 用户自发推荐
- 1
关于这组内测数据
当前记录的三周留存为 >30%。这是早期内测信号,统计样本、时间窗口与计算口径待补充;加群兴趣、测试用户和较高粘性用户分别记录。
WHAT I TAKE FROM THIS
“这句话,
让我更像自己。”
最难的,是把这种感受变成可验证的产品机制。
从价值假设到 AI Workflow,再回到真实的人。
← 返回作品
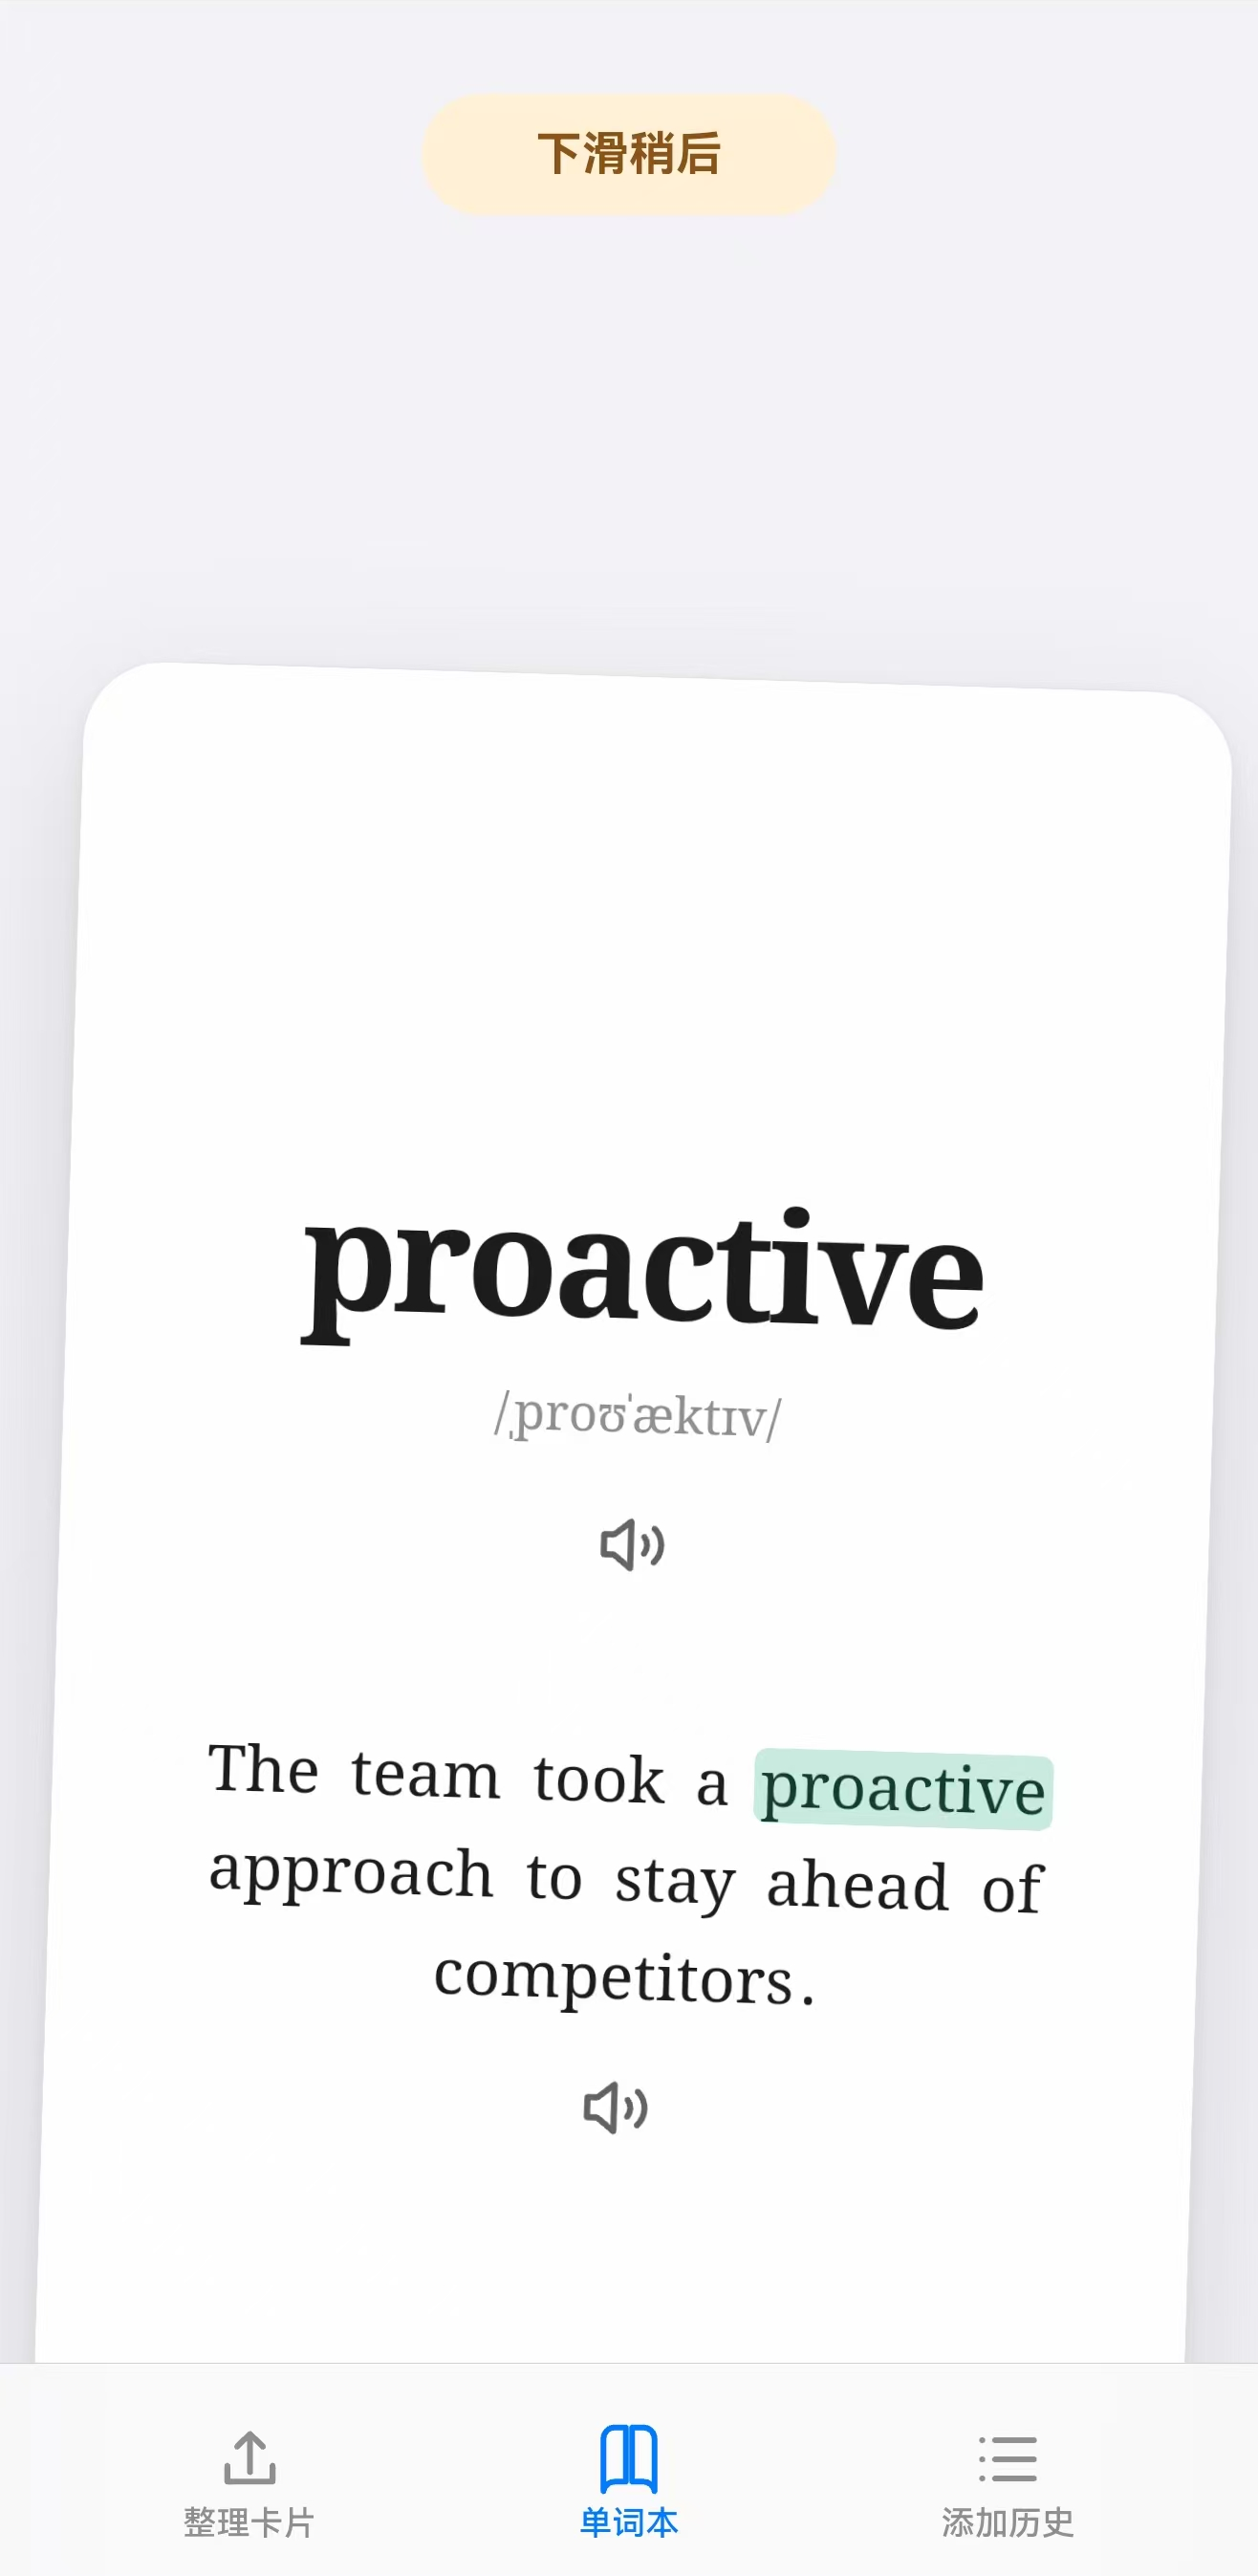
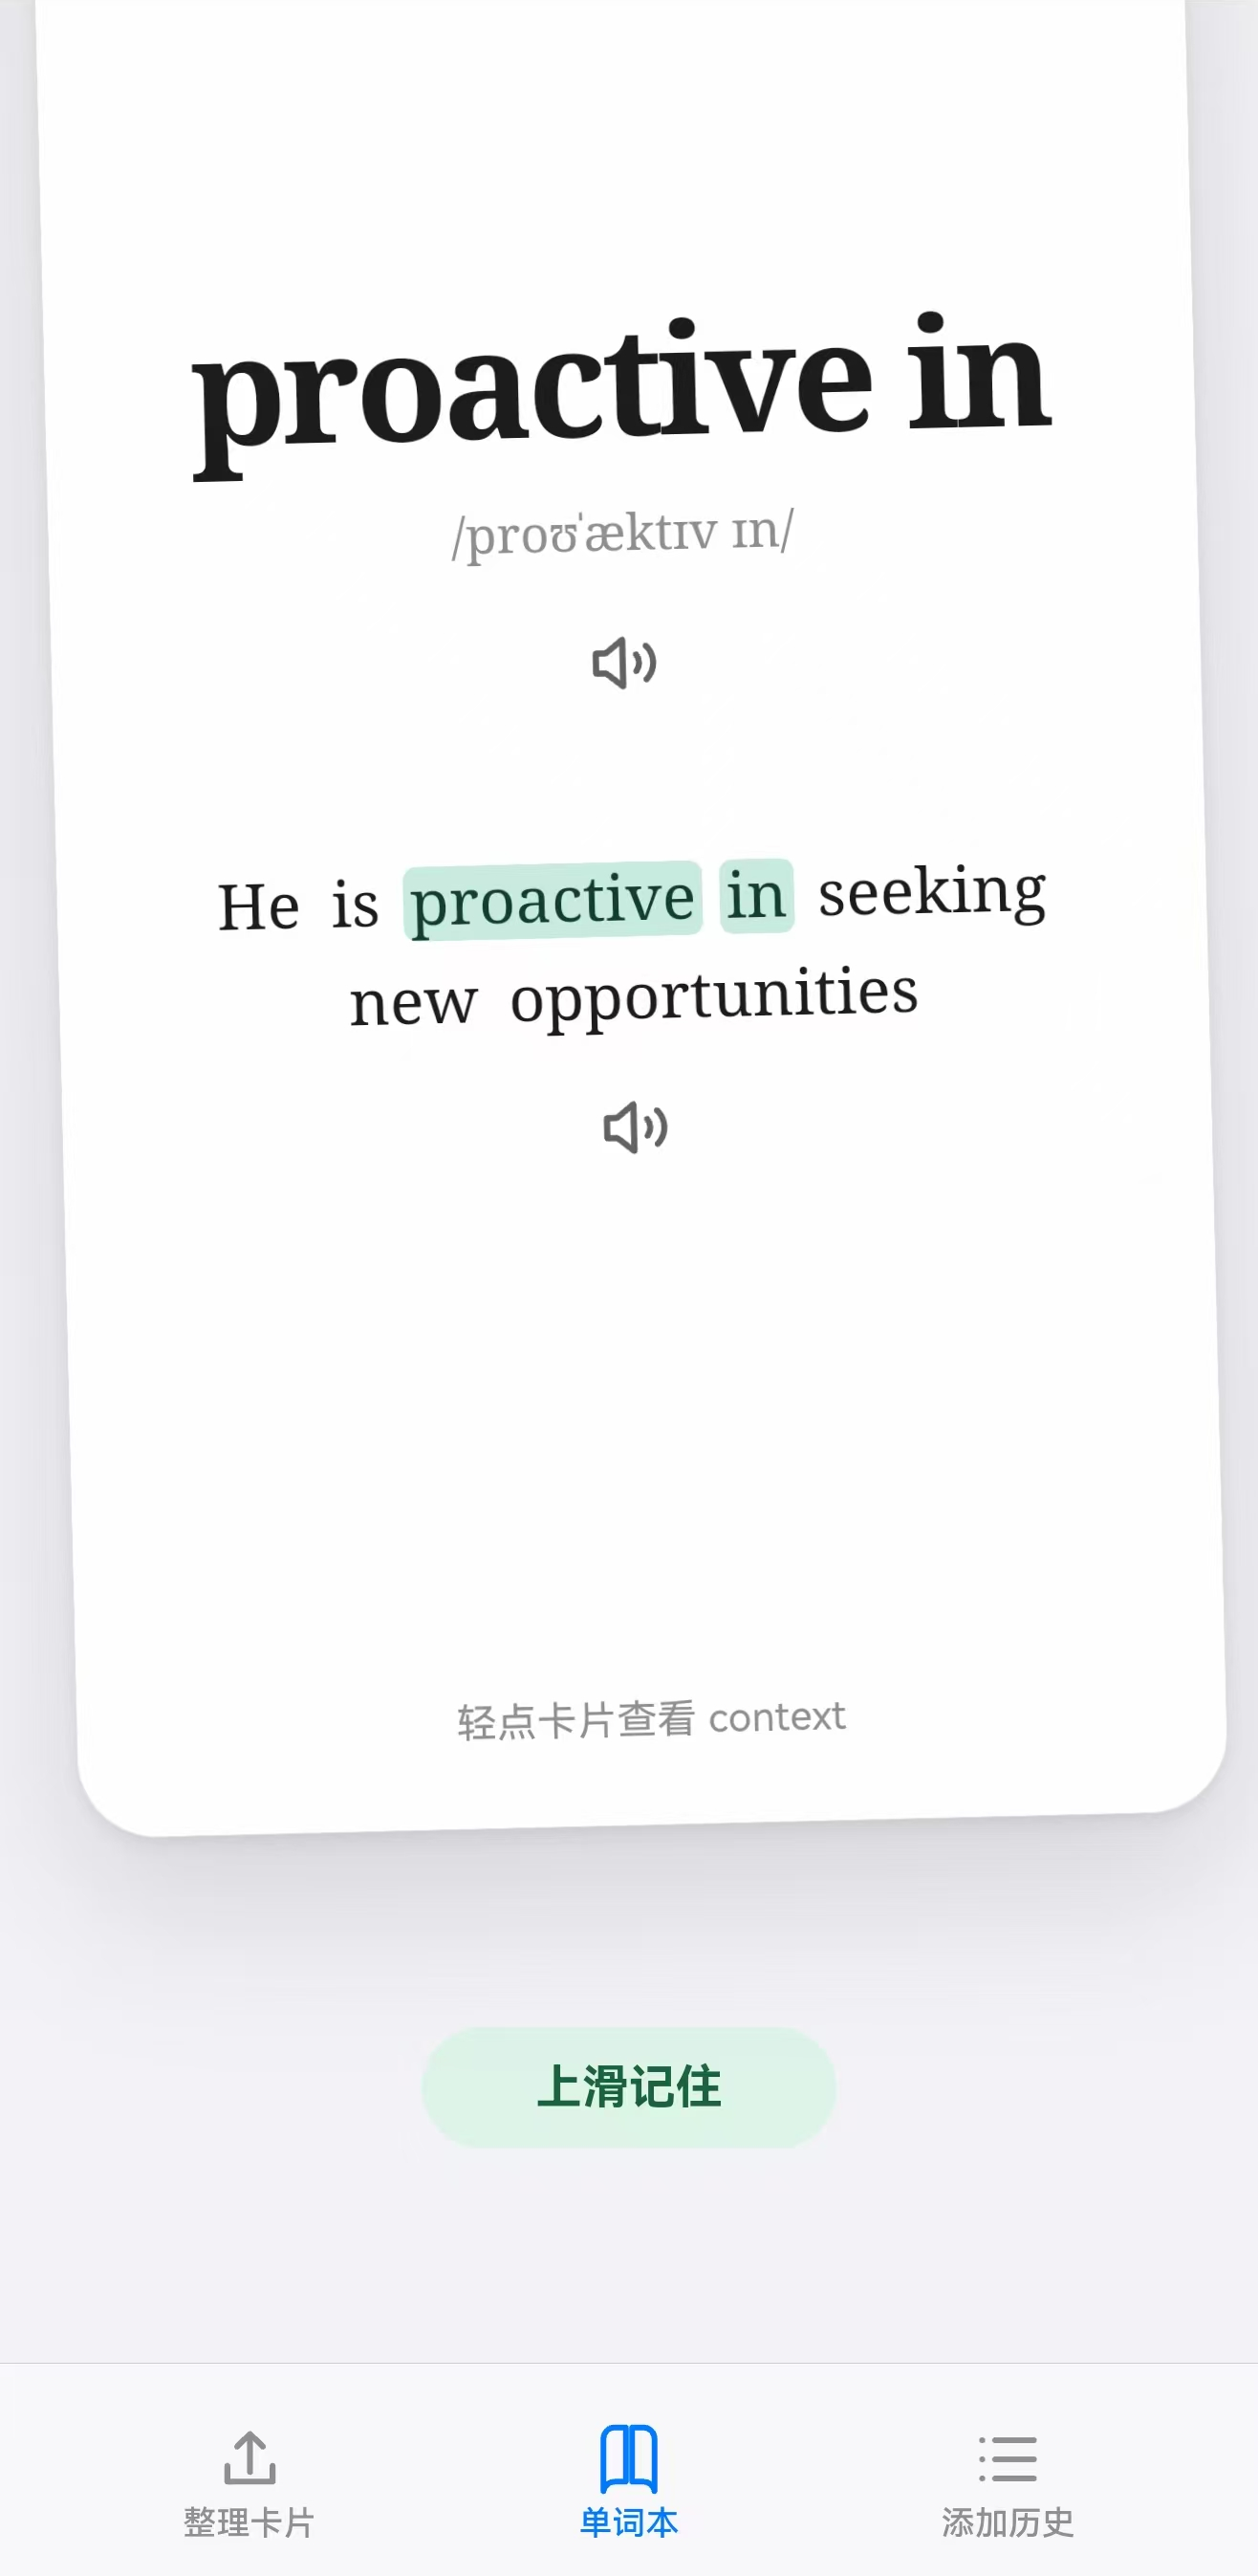
截图词典 Contextual Collector
个人工具 · 产品设计 · 非商业化
让单词回到你遇见它的那句话里。
一个把截图、OCR 原句和生词卡关联起来的个人词汇工具。十格容量和倒计时让收集回到处理,而不是无限囤积。
10 格单次容量
截图收词入口
原句保留语境
个人用非商业化
01 / 项目背景
词典给出定义,却没有你读到它时的那句话
总是遇到只懂一半的英文单词。离开原句查词,得到的是词典定义,却丢掉了当时的语境;同一个词的不同意思也容易混在一起。
记住一个词,往往要先找回它出现时的真实语境。
Contextual Collector 因此把单词和它所在的原始句子一起收集,让复习能回到真实阅读场景。
02 / 需求调研与产品定位
确认这是一个有价值的小众需求
01
语境优先
围绕用户实际遇到单词时的原句设计收集和复习体验。
02
个人工具
调研潜在用户后,确认需求存在但受众小众,因此保留为自用工具,没有商业化。
03 / 产品机制
从截图捕获,到带着语境复习
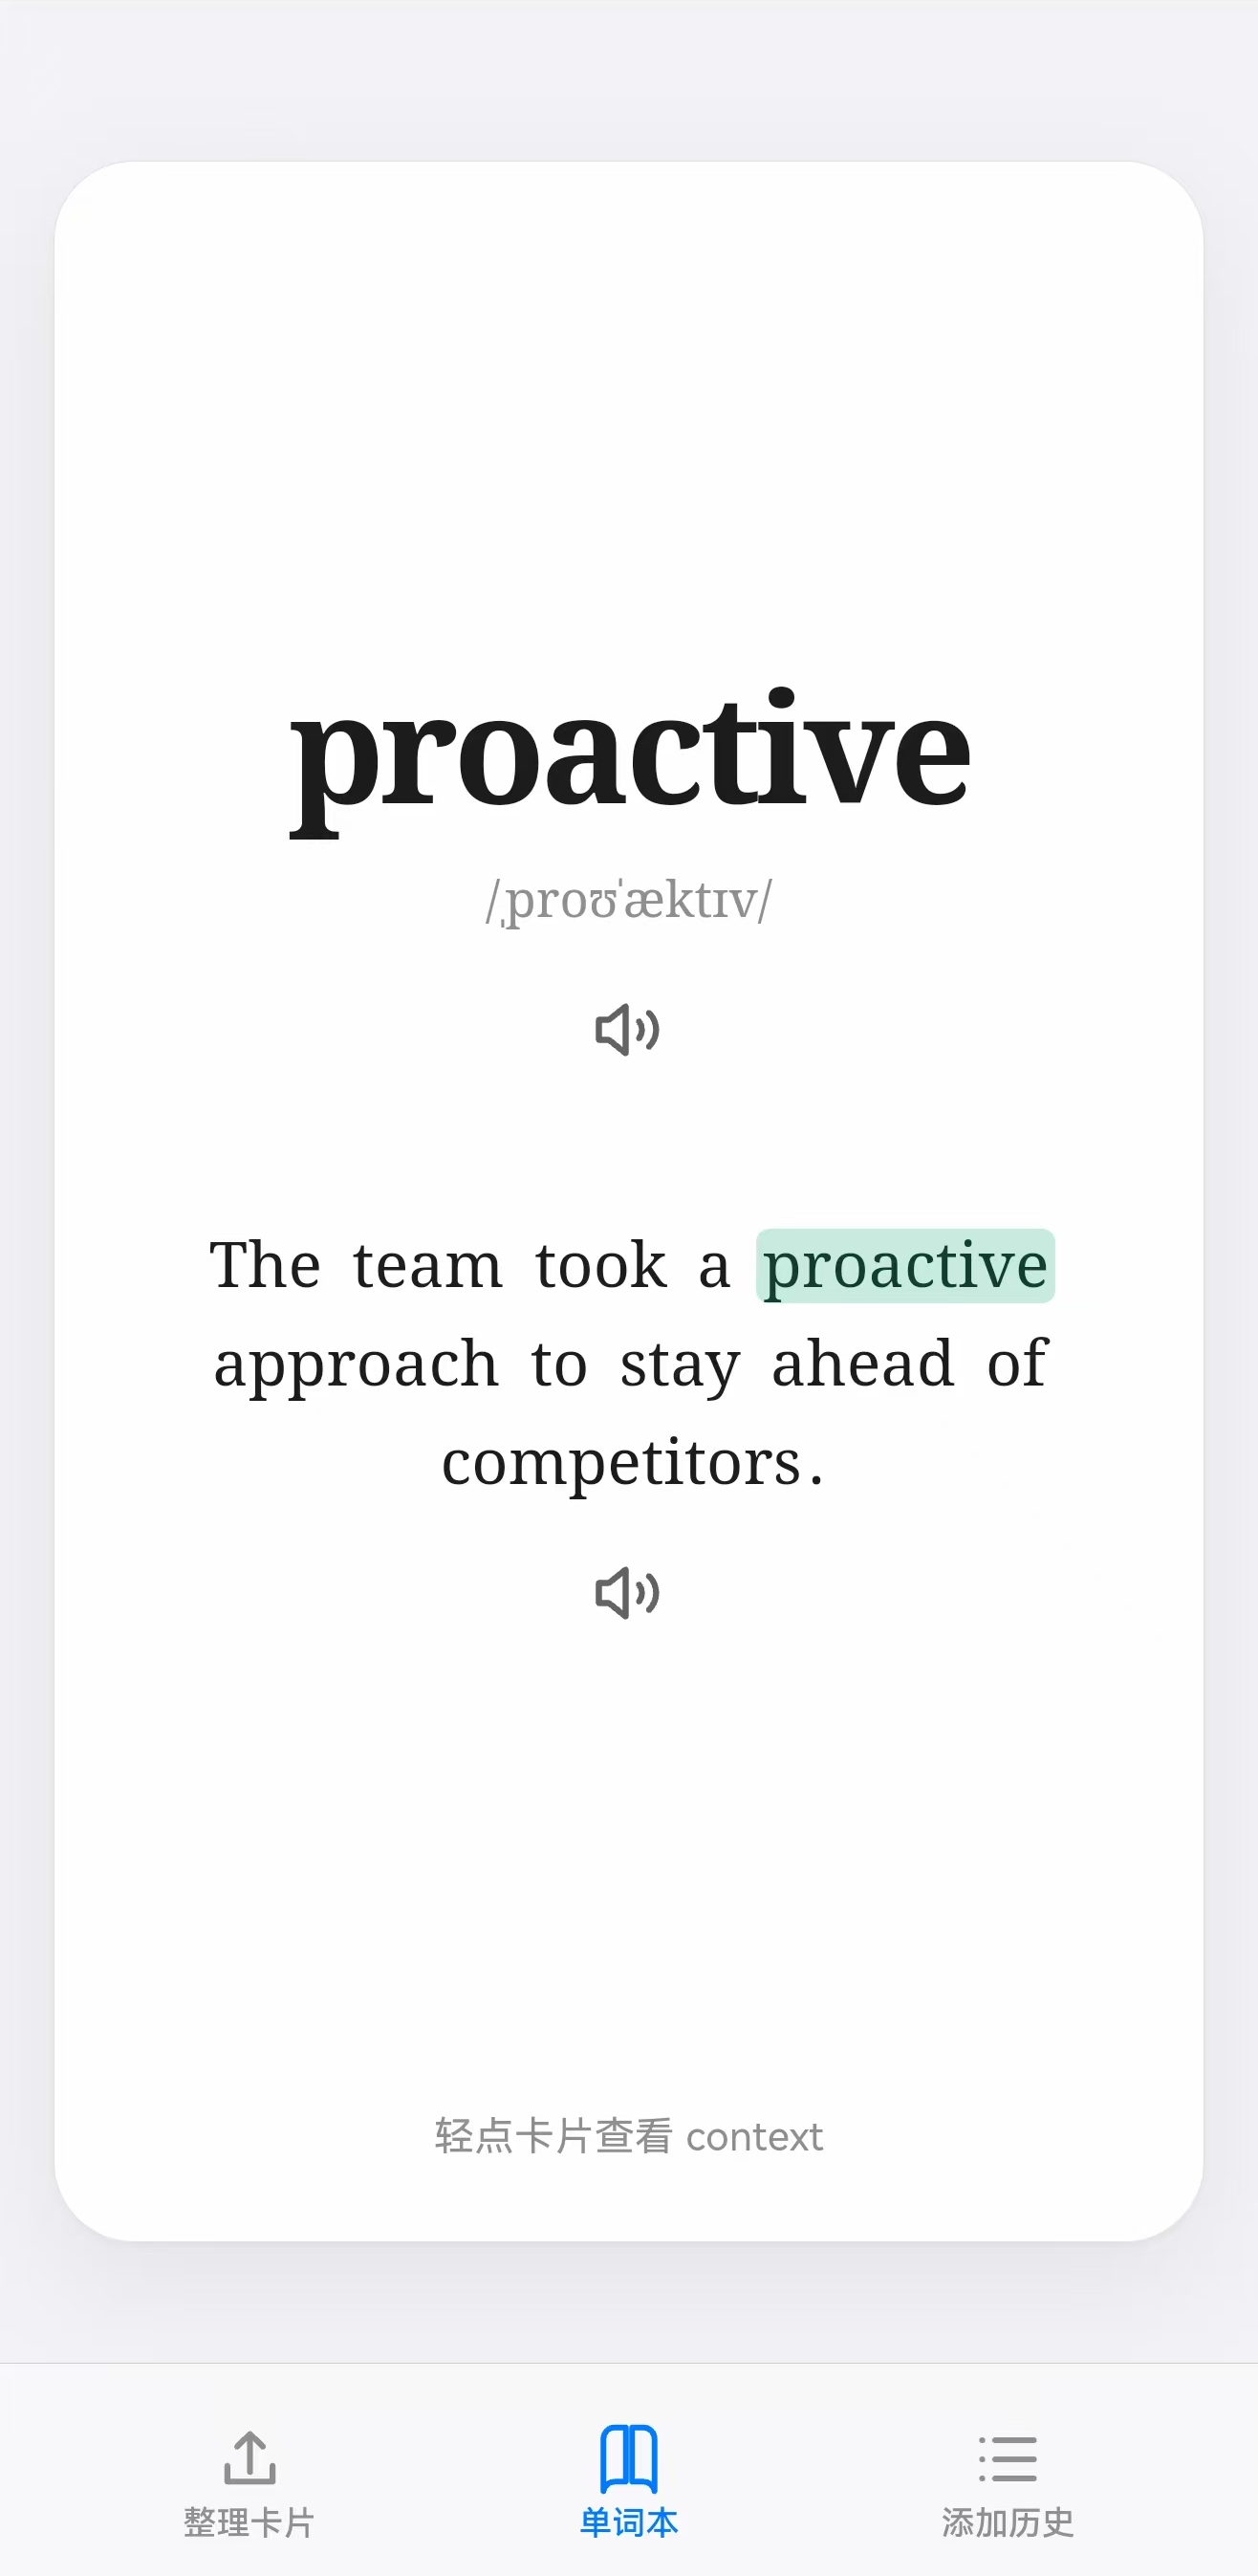
截图将单词与 OCR 识别出的原句一起放进悬浮气泡。复习时通过词卡浏览,把词重新放回当时的阅读语境。
截图遇到生词
→
识别保留原句
→
收集悬浮气泡
→
复习词卡浏览
04 / 交互约束
十个格子,让收集必须回到处理
词库只有十个格子。倒计时促使用户处理已有词条后再补充;容量有限是产品的主动设计,让稀缺帮助用户完成复习。
容量上限
最多十个待处理词条,避免收集变成无限堆积。
倒计时
用时间压力提示处理已有内容,再继续收集。
05 / 语境与复习
用真实句子区分相近词义
原始 OCR 语境
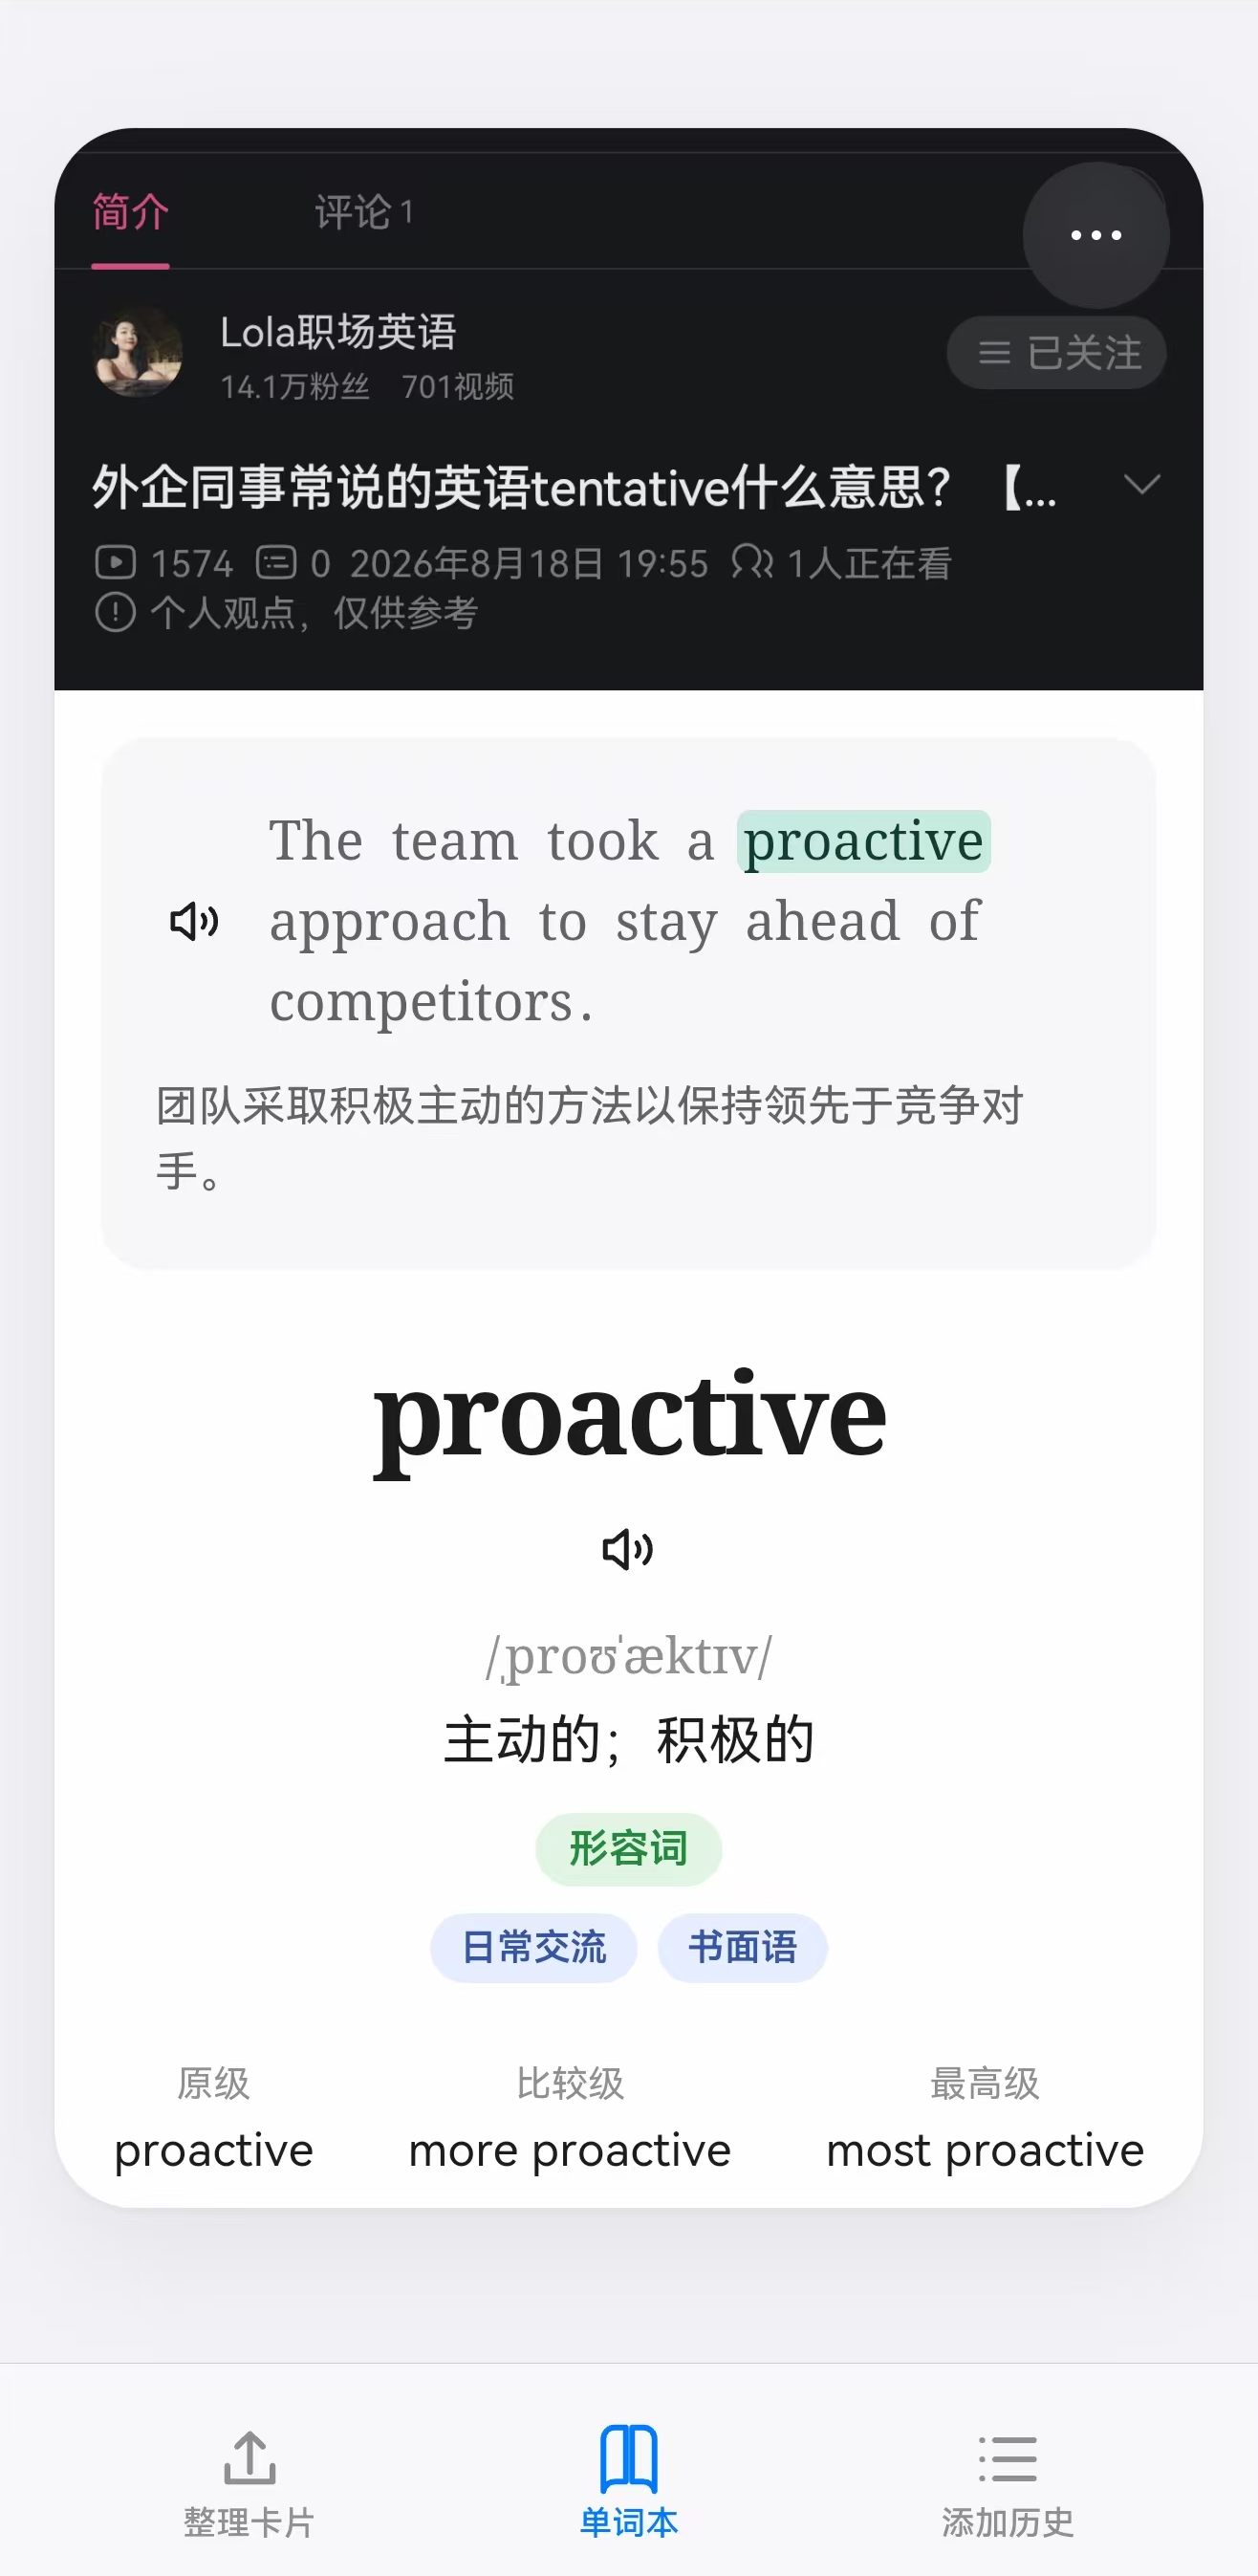
单词不脱离它出现时的句子,用户可以回忆原来的阅读上下文。
短视频式卡片
复习以连续浏览词卡的方式进行,让查词和回顾形成轻量闭环。
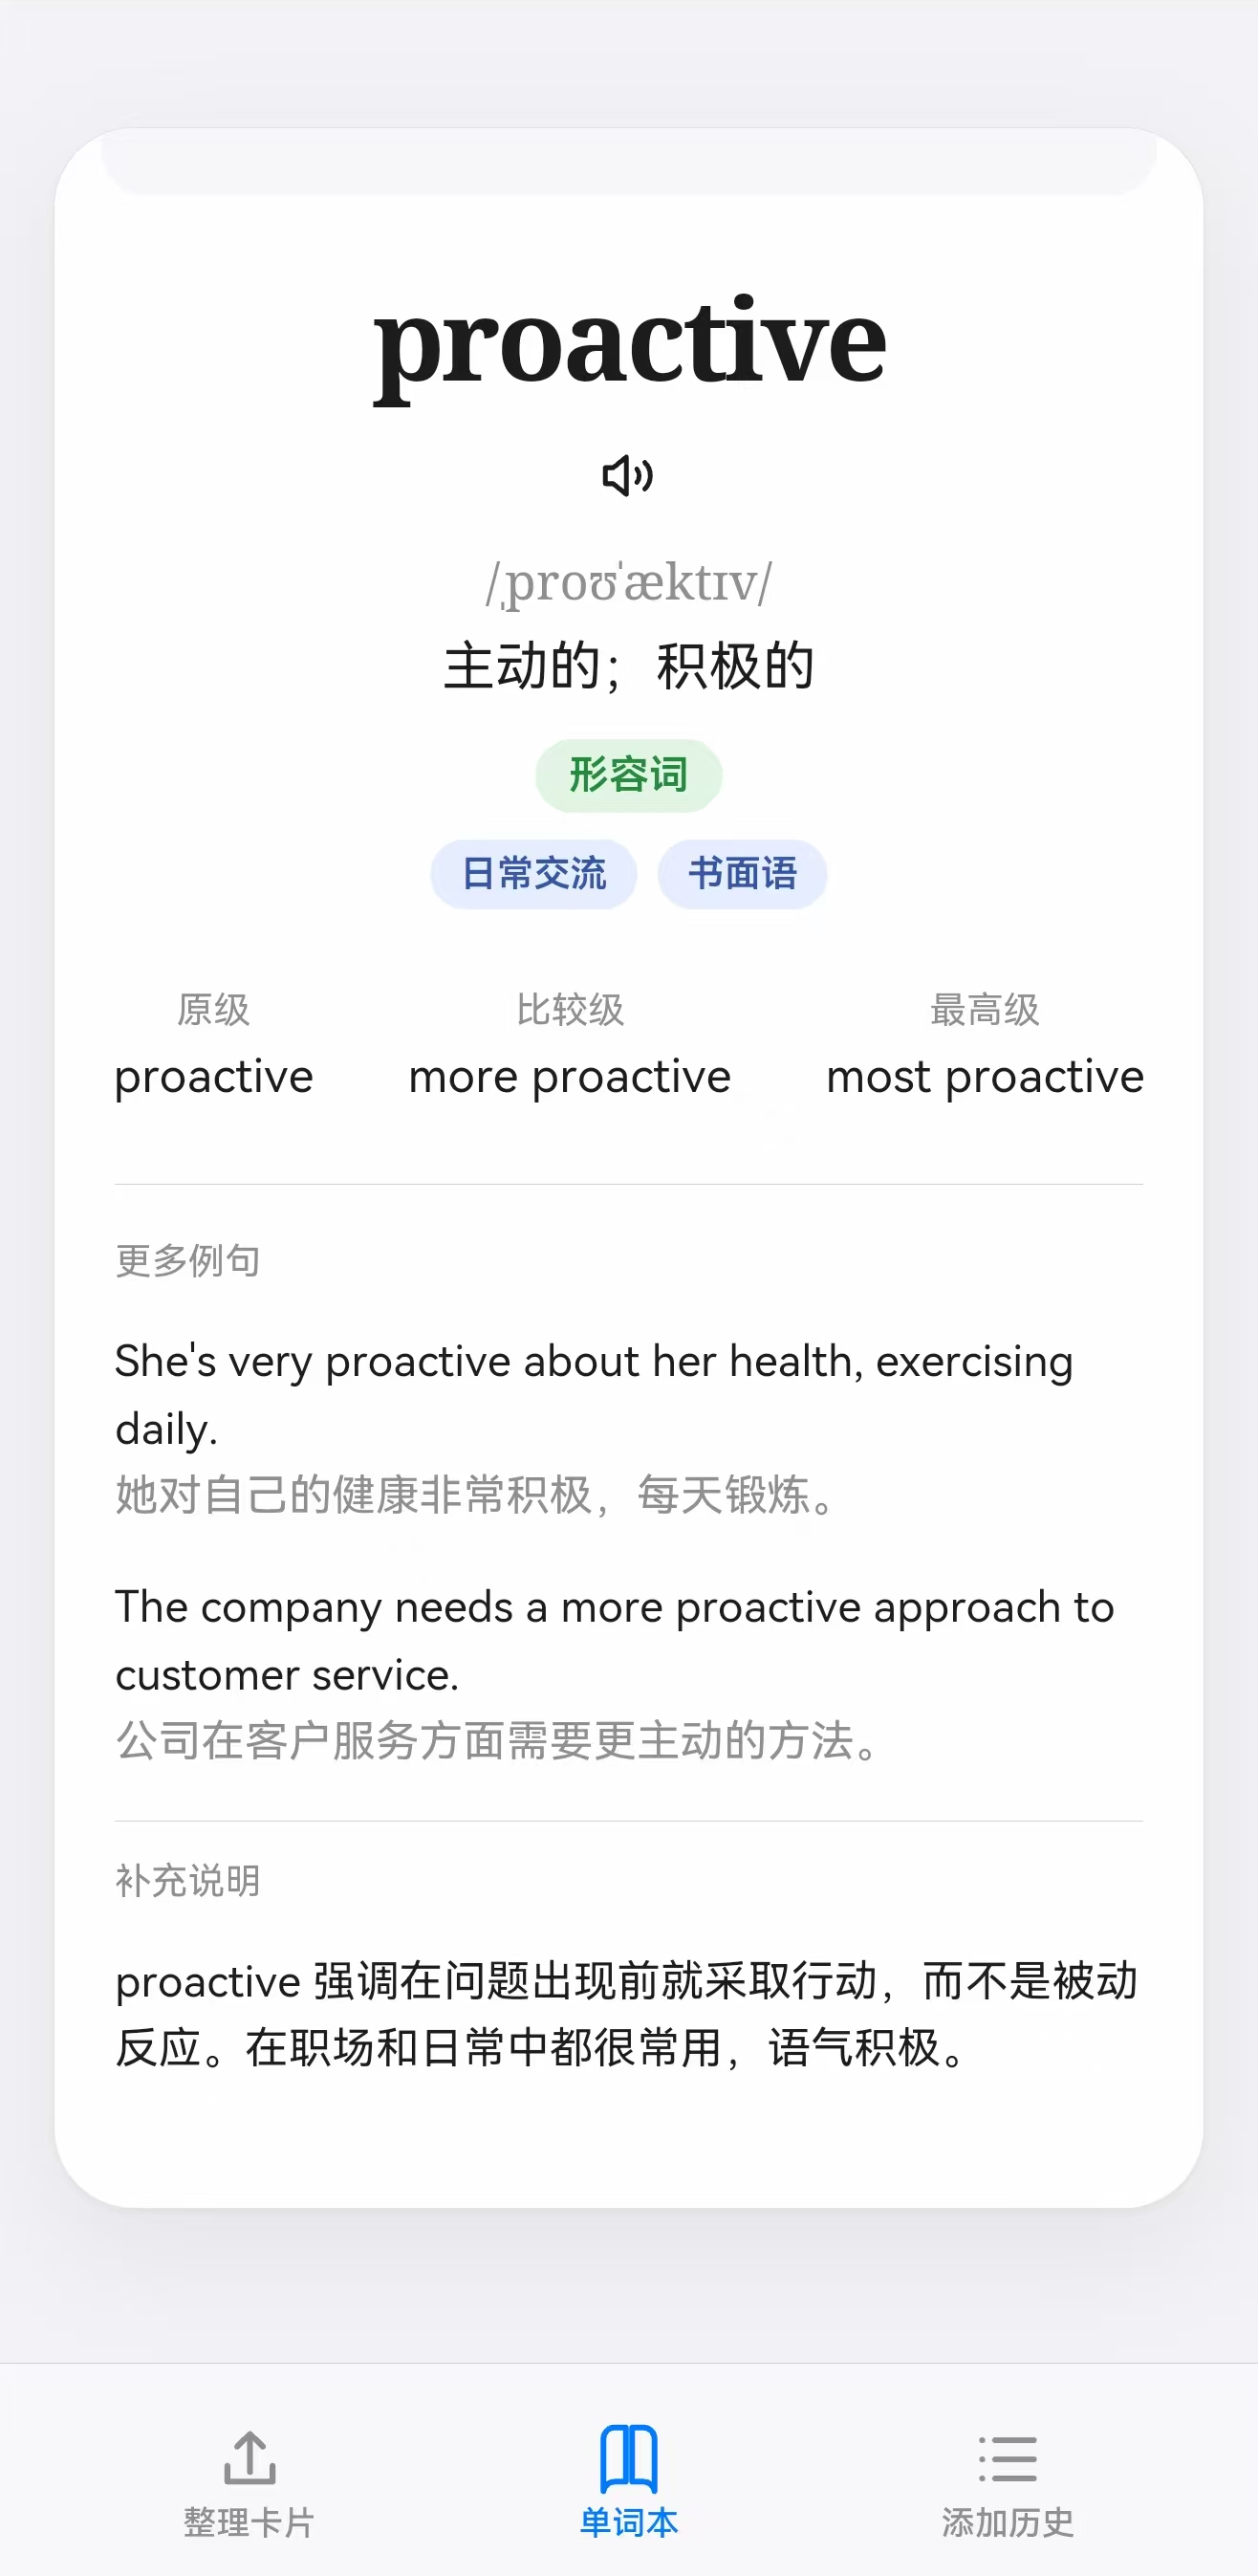
真实句子帮助用户分辨同义词和多义词,补上单独词典释义缺少的语境信息。
06 / 项目结论
为明确的小众场景,做好一个轻量工具
10词条容量
原句保留阅读语境
自用不做商业化
用户调研确认这是小众需求,因此产品定位为个人工具。它的核心价值是将生词、原句和复习放在同一个轻量流程里。
产品复盘
收集的上限不是缺陷,而是让每个词重新回到阅读和处理之中。
语境是记忆的一部分,有限容量则让复习有机会真正发生。
← 返回作品
内容反馈 / 社群互动可补充帖子数据和早期社群反馈截图
对话样例 / 模型输出比较可补充不同阶段的真实对话和模型评估记录
减肥搭子 Why Bother.
独立产品 · 陪伴型 AI · 开发中
减肥这件事,需要一个愿意说真话、也一直在的朋友。
一款围绕闺蜜人设设计的陪伴型聊天机器人。不要求用户记卡路里,通过三阶段语气和关系熟悉度,提供持续、直接的陪伴。
300单条帖子曝光
20+兴趣表达
9加群人数
2测试用户表达购买意愿
01 / 项目背景
为什么减肥 App 常常坚持不到一周
很多减肥 App 把重点放在记录卡路里,用户很快就会放弃。产品观察发现,人们需要的可能不是更多数字,而是一个会说真话、又持续在场的朋友。
把“监督我完成记录”换成“有人理解我,也愿意直接说”。
减肥搭子以闺蜜关系作为产品入口,用陪伴和逐步建立的熟悉感承接用户的日常状态。
02 / 早期需求信号
从内容互动到社群兴趣
早期内容发布后,单条帖子获得 300 次曝光,20 多人表达兴趣,9 人加入社群。这些信号用于观察用户是否愿意继续了解产品。
01
内容触达
单条帖子曝光约 300,初步触达对减肥陪伴有兴趣的人。
02
持续兴趣
20+ 人表达兴趣,9 人加入社群,形成早期用户沟通入口。
03 / 陪伴体验设计
关系逐步熟悉,语气也随之解锁
闺蜜人设一次性生成,避免每次对话都重新定义角色。随着对用户的了解增加,聊天语气从试探、直接逐步走向犀利。
试探建立熟悉感
→
直接表达更坦率
→
犀利关系更熟悉
语气随了解逐步变化,不靠套路推着用户走。
04 / 模型与语气
中文情感场景里,语气选择就是产品体验
角色生成
闺蜜人设一次性生成,保证陪伴关系有连续性。
模型选择
项目选择 Sonnet。测试中,DeepSeek 在中文情感场景里的表达被评价为“太爹味”,不符合预期的朋友语气。
05 / 商业模式
用户免费,尝试由转化覆盖陪伴成本
计划采用 ToB affiliate 分成,用户不付费。每位用户的模型成本约 ¥70/月,按现有估算,两笔转化可以覆盖成本。
用户侧
不向用户收费,保留轻量的陪伴体验。
商业侧
通过 affiliate 分成覆盖模型调用成本。
06 / 测试信号
一句自然的回应,触发了购买意愿
2测试用户表达购买意愿
9加入社群
开发中产品阶段
两位测试用户在机器人随口说了一句话之后,就表达了购买意愿。这是早期的体验信号,说明角色语气可能影响用户对产品价值的感知。
项目复盘
真正的陪伴感来自持续理解和合适的表达,而不是多一张卡路里表。
当前处于开发阶段,早期内容互动、社群加入和测试反馈为后续产品验证提供了线索。
← 返回作品
shelter Early exploration.
早期探索 · 手绘视觉与音效 · 2025.08 — 2025.10
给注意力,搭一顶小帐篷。
从手绘开始,探索一个让人愿意停留的空间。
shelter 是一个围绕专注空间的早期探索。以手绘帐篷和篝火为起点,尝试用画面与声音营造暂时远离外界干扰的氛围。
早期手绘探索 / 氛围与体验